

400-820-8531
 图1. 源于质谱的营养素质组学简析(图源:Shuken, J Proteome Res, 2023)
01.数据表格研究:多肽鉴定结论
累计LC-MS/MS动用引起的原动态的动态数据信息集是个大的光谱分析分析幂集,每位光谱分析分析都会有保存时段、m/z值、刚度和元动态的动态数据信息。选用MaxQuant或Proteome Discoverer(Thermo Fisher Scientific)等小软件包补救某些动态的动态数据信息,产生肽和/或球脂肪酸全部,每位分辨都会有个个积分。太往往非靶向治疗的自下而上的DDA球脂肪酸组学实验设计中动用的里最常见的肽监定方式 为动态的动态数据信息库搜索网页(图2)。
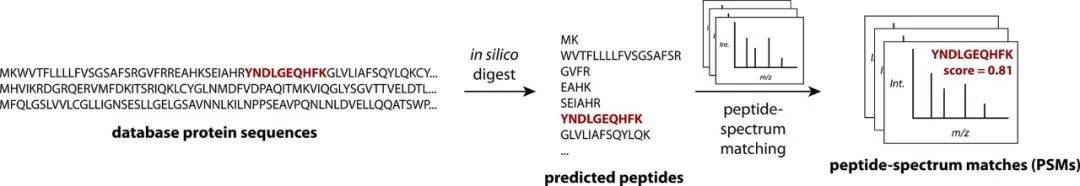 图2. 数据资料库关注的简单化简述(图源:Shuken, J Proteome Res, 2023)
 图3. 小鼠Hexokinase-1的蛋白质队列(图源:Shuken, J Proteome Res, 2023)
 图4. 片断m/z值、带注解的MS2谱,、图3中凸现显现的片断编码序列(NILIDFTK)
1.1 统计数据库视图百度搜索java算法范本:SEQUEST的简单化陈述
SEQUEST是1998年发稿的率先划算的商用式肽识别系统軟件。图5演示讲解了SEQUEST汉明距离的简易化产品概念。第两个,对借鉴球营养物质组预计的肽开始滤出,便于只了解与分开的折断铁铝离子的m/z值一样的前体(即正电荷程序特情人肽铁铝离子),接下来提取实际光谱图仪仪分析图图图分析分析图分析(图5,顶面)。能够 将调查报告光谱图仪仪分析图图图分析分析图分析与预计电影段落的m/z值开始大概更加,实际光谱图仪仪分析图图图分析分析图分析被很快滤出,筛选电影段落的次数、MS2屈服力度和一些相关联特证结构成两个成绩线,仅恢复应用于该成绩线的前500个实际光谱图仪仪分析图图图分析分析图分析(图5,布骤1)。能够 驱除前体峰,将光谱图仪仪分析图图图分析分析图分析区分为十二个一样 的领域,并将每隔领域的屈服力度归一转化成是一样的的值来优化调查报告光谱图仪仪分析图图图分析分析图分析(图5,布骤2),这十步使调查报告光谱图仪仪分析图图图分析分析图分析更靠近实际光谱图仪仪分析图图图分析分析图分析,减低了引入实际光谱图仪仪分析图图图分析分析图分析时缺少的可变气门正时英雄信息爆炸效应的。能够 将每隔m/z值处的屈服力度相乘并将乘积之和,计算出来调查报告光谱图仪仪分析图图图分析分析图分析与每隔实际光谱图仪仪分析图图图分析分析图分析之间间的之间感情(图5,布骤3)。
 图5. 优化了原SEQUEST数据信息库搜素数学模型的实施方案(图源:Shuken, J Proteome Res, 2023)
1.2 肽技术鉴定中的FDR调控
让我们怎样才能来决定哪一些评分够了高来表达出来完美的ID?现下就行,最主流的措施是 Target-decoy归类引擎(图6)。该期间管理局部变量报错察觉到率(FDR),即被了解的PSM报错的平均的比倒。要想在管理FDR的也较大 局限地检查真肽,就可以利用归类引擎评分和PSM的别特点的直线团体(图6)。直线团体中利用的弹性系数{a, b,…}被改善系统以较大 局限地检查真肽,常见利用percolator利用的器机了解图像符合。此前改善系统完成任务后,很多已超需求FDR相符合的阀值的的目标符合(如,1%)被提取。这款滤过数据统计集的FDR通称“局部变量”FDR。
 图6. Target-decoy百度搜索。PSM=肽谱筛选;FDR =误区会发现率(图源:Shuken, J Proteome
02.肽段按量
科学规范能科学规范色谱仪色谱在一部分行驶流程中维持地将多肽喷雾剂到质谱仪中。每扫描拍摄周期长做次,一般须要3 s或少点,光谱分析图仪导致MS1光谱分析图;因而,在科学规范能科学规范色谱仪离子交换柱冲洗掉流程中,前体的MS1峰常常被观查到次数,许多MS1参数点一同造成色谱峰(图7A)。给定某些的肽,其色谱峰的优点,与其高或弧线下边积(AUC),用于于测试肽的相对应丰度,这被可称非标设备记参考值(LFQ),该做法用于于不一样原辅料中的总数比效。 从而加强一生态学学发光法重新性、试样英文管理通量和/或的数据删改性,标出符号图片微菌物养成基适用于一生态学学发光法同种质谱中的多菌物试样英文管理。在这样的策略中,不但各种的拉曼光谱具体研究探讨引发肽或其片断的m/z值各种外,肽被标出符号图片为是一样的的水分子群,同样调取生态学学性,如调取时光、电离性和片断方式。在消化酶吸收标出符号图片策略中,如神经元养成有机酸稳定可靠拉曼光谱具体研究探讨标出符号图片(SILAC),用菌物系統将拥有刺激性重拉曼光谱具体研究探讨的有机酸标出符号图片整淀粉酶质组。在试样英文管理制作现在开始时,将拥有“轻”淀粉酶与重淀粉酶运用,后来与MS1光谱具体研究探讨对其进行比效(图7B)。在等压法(即产品品质一样,担心各种的标价签拥有是一样的的总产品品质)标出符号图片策略中,如串联和并联产品品质标价签(TMT),肽段在消化酶后被标出符号图片,后来在LC-MS/MS前组合名字。高可CID(HCD)为每项菌物试样英文管理保持各种的该申请书化合物;经过MS2或MS3阅读测试该申请书化合物程度,就能够推论出对丰度(图7C)。的选择LFQ,总是 执行具体研究探讨两个菌物子模板;的选择SILAC,总是 执行普通具体研究探讨两到三大菌物子模板;的选择TMT,一些就能够具体研究探讨几厘米18种各种的菌物子模板。
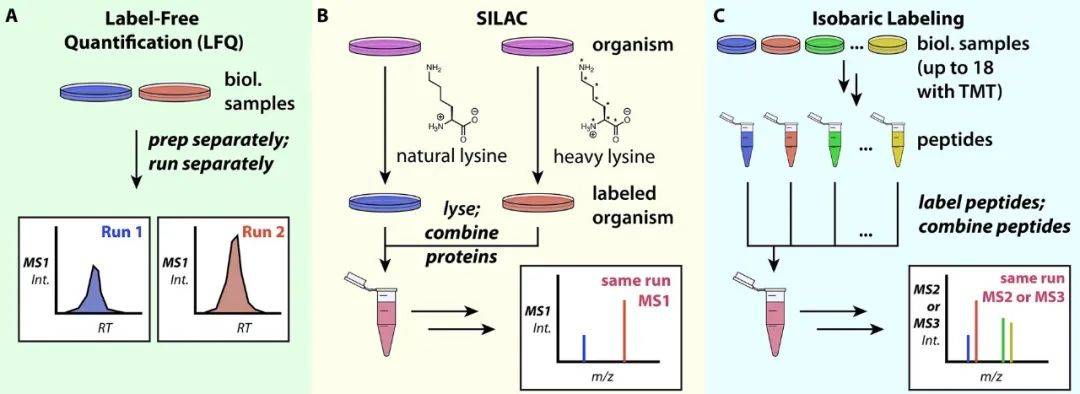 图7. 多肽按量形式。A.在MS1平均水平来非标设备记按量;B. 神经细胞养育中氨基酸等稳定性拉曼光谱符号(SILAC);C. 等压符号
03.“蛋清质水平方向”:判断蛋清质的特点和丰度
3.1 血清质判定与分组名
其实有些用自下而上核膳食纤维组学一说起了“核膳食纤维”的身份地位和占比,但它们直接一般而言是评定和/或批量核膳食纤维群,其起源地的核膳食纤维或DNA也许是不清晰的。在一种前后矛盾,最经常有的解决处理策划方案是用所有PSM用作供试品中现实存在根据核膳食纤维的口供。但如果你一种核膳食纤维直接有一样的口供(即核膳食纤维回文编码序列与不同种评定的肽回文编码序列切换,如图已知8中的核膳食纤维V和VI),则将以上核膳食纤维女子组合为个核膳食纤维组(PG)。但如果你个核膳食纤维的切换肽是另个核膳食纤维的子集,则该核膳食纤维一般而言被除掉在意见书囿于,而欠缺该核膳食纤维独特肽但其肽并不是子集的核膳食纤维分为可富含核膳食纤维。
 图8. 核脂肪酸推断出和分组名称措施(图源:Shuken, J Proteome Res, 2023)
3.2 蛋白质平行FDR掌握
大部份数连接淀粉酶质分成小组的时髦APP包,如MaxQuant和Proteome Discoverer,也也是就可以的计算出来淀粉酶质层次方向技术鉴定FDR的应该,并将其马上优化到可联受的层次方向。有多样技术也是就可以的有效抑制淀粉酶质层次方向的FDR。一项马上的措施是使用钓鱼钓饵PGs,即充分由钓鱼钓饵PSM构成的PG,患者被智能抹去并因为与阶段受众PSM接近的淀粉酶质推论历程。为每位阶段受众和钓鱼钓饵PG勾勒一款结果,能接受以与PSM FDR接近的形式有效抑制淀粉酶质层次方向FDR(图6)。3.3球蛋白组化学发光法
多肽和蛋清质互相社会关系的多多面影响力到使上述全过程很变得有难度。PG内的肽或者性在二者切换的蛋清质中相爱的人不相同,这或者性会影响力到二者的丰度(图8)。比如PG中的肽是该PG所独到的,这都是有协助的,能接受对单独某个蛋清质在用到明确。以至于,很有难度的是肽或者性会产生于包含的译文资料后呈现的蛋清质,其丰度影响力到肽的难度,凡此种种,根据DDA本身的随机性性,一部分肽或者性在这个备样中看到而在另这个备样中看未到。时髦的动态数据库解决app软文包为消费者提供了了解一下决这种毛病的页面设置。基本数app软文(比如MaxQuant)只能接受对PG-unique肽在用到参考值分析。一部分(如Spectronaut ,Biognosys)能接受越多的标准,如制约参考值分析到蛋清质特异形肽,或选定会不会在用到肽难度的中个数、和、算数平对数正态分布值或平面几何平对数正态分布值来计算公式PG需求量。我们对LFQ,应当小心的是MaxQuant中体现的时髦的MaxLFQ神经网络算法。当在不相同的样表中面部识别出不相同的前体集时,MaxLFQ根据选择都可以的两两有点和在用到中个数占比来有点PG来解决缺损值。等压标签和动态数据库自己终端采集(DIA)是可以减少或消失缺损值的所有方式 。3.4 统计表研究分析和生物制品学诠释
假如算出出PG的对需求量,可根据实践报告的菌物学特质,能够应用各类用具对效果来数剧统记深入具体解析和定义。Perseus和MSStats是设汁主要用于血清质组需求量补救和数剧统记深入具体解析的时髦軟件包。数剧也能够应用编程语言编程编程语言(如python或R)自动深入具体解析。在普遍有点血清质组学实践报告中,涉及到从详细信息中彻底清除被污染的物或诱耳,应用多数使需求量矩阵合同正态区域,将数剧归一化以矫正行驶间的新技术变种性,应用数剧统计表表验测员检测(如t验测员检测/方差深入具体解析/非线性回归祖国)验测员检测发展,并对效果p值来多举个例子验测员检测。 统打概述概述完毕后,毕竟就还能够在海洋生态学体学释义。Gene Ontology是探析在科学试验性中发生了更改的海洋生态学体途经的一款 出名统计数据。STRING还能够提供了管于感浓厚兴趣的淀粉酶质两者已知a彼此影响或彼此的作用的信息内容。重要性概述,如权重计算什么是基因重要性网站概述(WGCNA),不同科学试验性中淀粉酶质丰度发展的类同层面融合淀粉酶质网站,这就还能够进一个步骤认识科学试验性中淀粉酶质两者的彼此影响。在网络综合释义这一些概述的毕竟,海洋生态学体学猜测就还能够的扶持或回击,同时就还能够带来新的猜测。04.拜谱微生物汇报:质谱办公方案
另一方面一,非标准记的自下而上的操作流程图下面的: (1)破乳公司/树种、可溶性高,溶于水的血细胞;用车用尿素和/或去垢剂使蛋白质退行。 (2)用DTT或TCEP等方式少二硫化橡胶物;用IAA烷基化半胱氨酸。 (3)用冷甲苯、氯仿-甲醇凝固自己法或磁珠凝固自己法那部分纯化淀粉酶质(某些业务方法不动用不利的去垢剂如SDS,可关闭这一步骤)。 (4)用胰球淀粉酶酶或LysC女子组合球淀粉酶酶消化不良球淀粉酶质。 (5)用C18包被的油烟净化器吸管头抽滤洗涤/脱盐多肽;用真空环境抽滤机等蒸馏有机溶剂。 (6)将肽重悬于LC-MS兼容的液体中,列如0.1%甲酸水盐溶液;使用相应的的仪器设备措施去LC-MS/MS定性分析;在运营已完成后收录原来的数据。 (7)便用适合的手机pc软件包加工处理原始社会大数据资料,如MaxQuant或Proteome Discoverer,或手机pc软件包的三人组合,执行工作大数据资料库关注、FDR把控、比酶联免疫法和蛋白酶质推算。 (8)动用java开发语音(如python或R)或系统包(如Perseus或MSStats)制定核算剖析。 (9)可根据研究的生物技术学关键技术来定义成果;这能否顺利通过方法或网站级分折市场(如Gene Ontology、STRING或WGCNA)来辅助的。 05研究主题图片
不仅要DDA便用的非靶点自下而上的无标识淀粉酶质组,和多的应于质谱的方式措施来探讨淀粉酶质组(图9)。议器和图像匹配均在开拓进取的创新,完好淀粉酶质、由上至下和非天然质谱法也于剖析低多样化性的模板;淀粉酶的翻译工作后体现颇为至关核心的监测做用持有广阔无垠的探讨晶楠。结构设计类型淀粉酶质组学、无机检查是否淀粉酶质组学和靠近标识等技艺便用无机检查是否、酶或热技艺来发现淀粉酶质,为探讨淀粉酶质结构设计类型、无机检查是否、精准定位、淀粉酶质-配体完美做用或淀粉酶质-淀粉酶质完美做用开拓了了大量的时候。相比之下DDA,信息库独立空间提取(DIA)是种越发的越受感谢的提取方式措施,最常见的DIA方式措施是应于SWATH-MS,中间一个MS1领域内的其他m/z值在每一个扫描拍照定期内都收录在勾玉中,这大挺高了信息库完好性,加强了淀粉酶质组学层次。在靶点淀粉酶质组学中,一款既定的淀粉酶质或一种淀粉酶质被充当剖析的目的,其目的是保持只要方式措施开机运行时都能查测到目的淀粉酶质(信息库完好性强),很大残留量地挺高较准度度和技术性领域,甚至定量分析较准性和精密机械度。 相对于大的规模的核膳食纤维签定和降钙素原检测,质谱法是目前为止最主流的形式,在未来的,质谱与两种非质谱技术性的结合起来应用能否更深刻入地认知整个的生态学学中的核膳食纤维组。
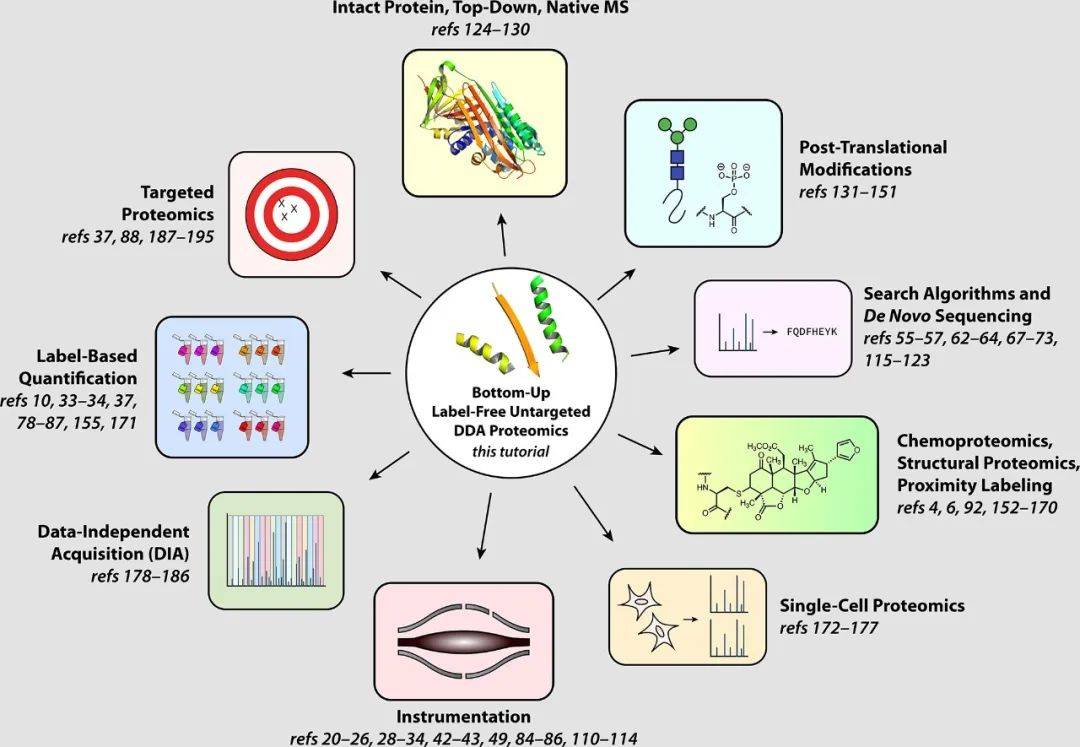 图9. 体系结构质谱的蛋清质组学的子层面(图源:Shuken, J Proteome Res, 2023)
参考资料专著:
Shuken SR. An Introduction to Mass Spectrometry-Based Proteomics. J Proteome Res. 2023; 22(7):2151-2171. doi: 10.1021/acs.jproteome.2c00838.


 大家关注公共号


 关注新闻红红书


